I Built a Trap for AI Image Judges. They Walked Into a Different One.
Senin, 12 Oktober 2026 pukul 11.00
Sumber Berita Asli
Towards Data Science
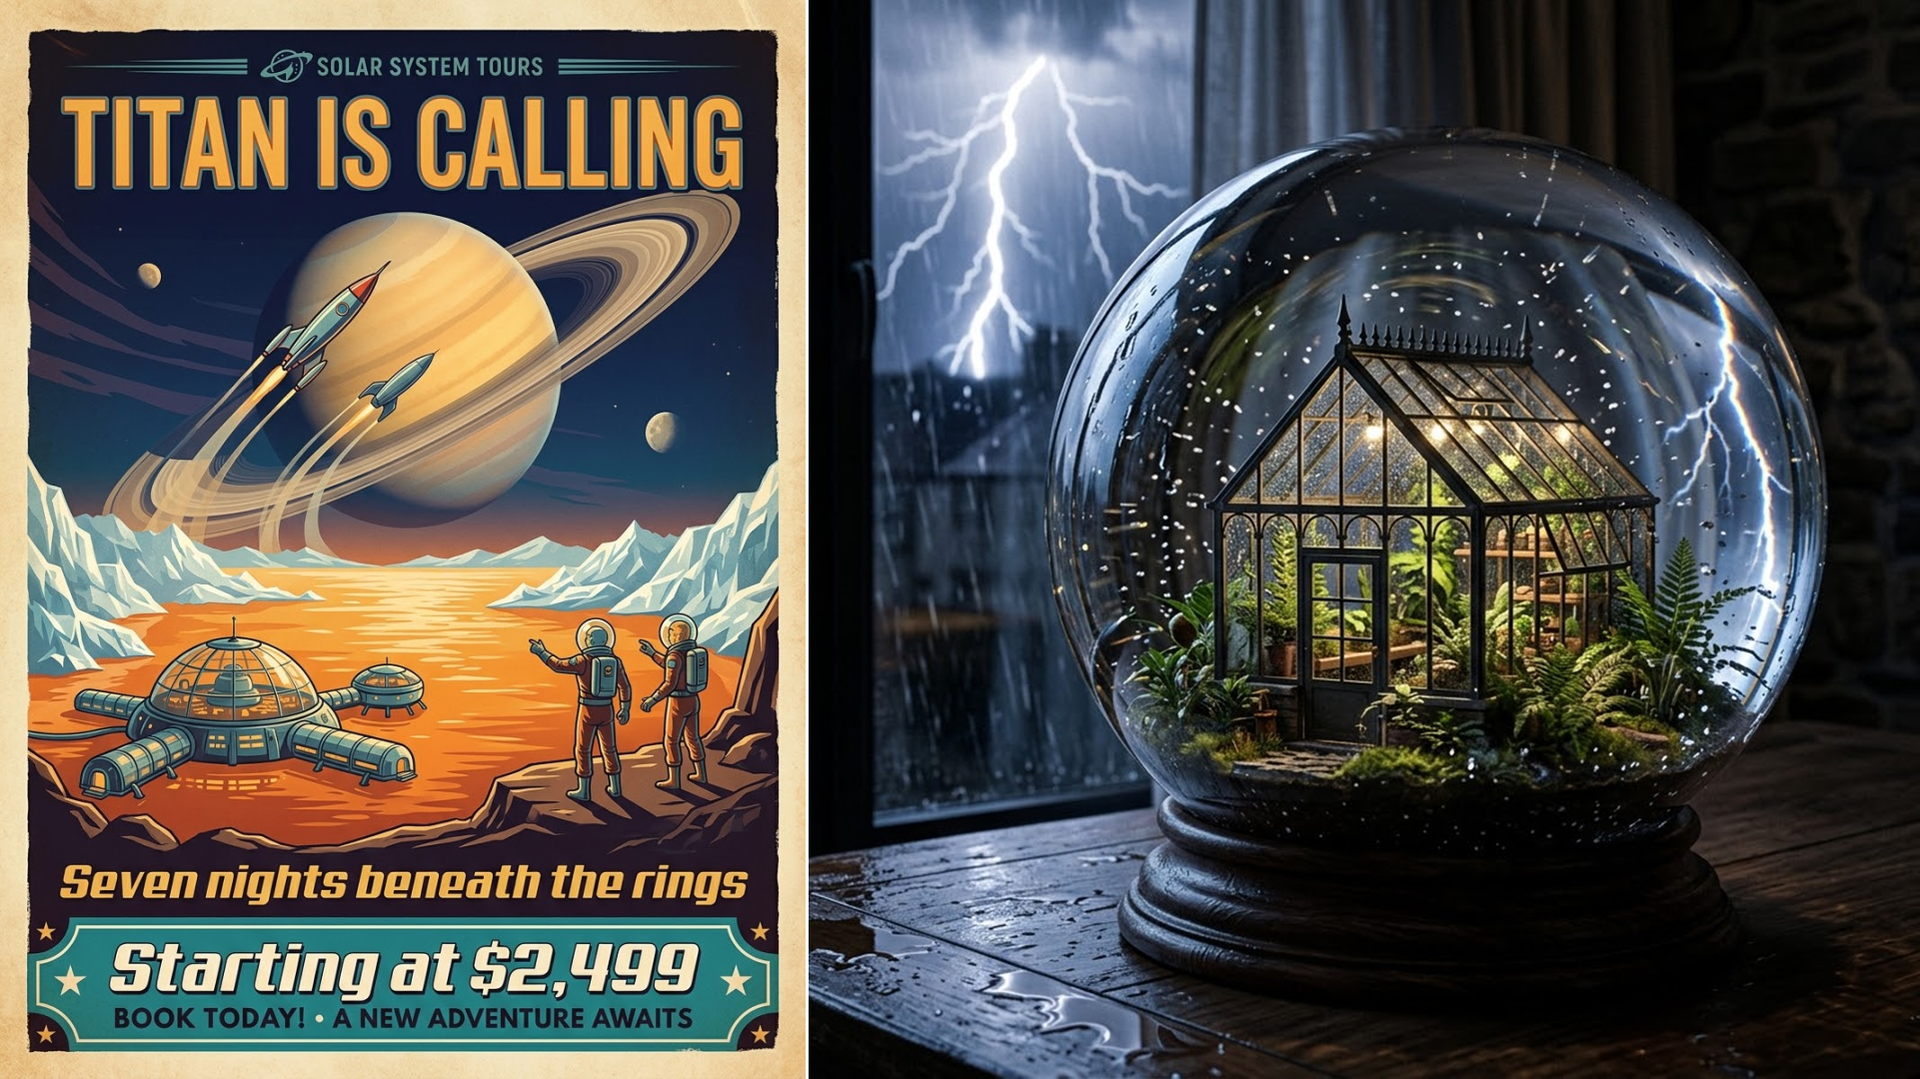
Penulis melakukan eksperimen untuk menguji kemampuan model AI dalam menilai gambar, dengan tujuan melihat bagaimana model tersebut merespons instruksi spesifik. Hasilnya menunjukkan ketidakmampuan dari tiga model visi AI untuk mematuhi aturan dasar yang diberikan, di mana mereka malah mengabaikan gambar yang diminta dan fokus pada elemen lain.
GPT-4o ditemukan mengarang jawaban secara tidak benar, sementara Claude terus memilih opsi 'B' meskipun sudah diberi perintah berhenti. Eksperimen ini mengungkap potensi masalah dalam keandalan model AI saat diberikan instruksi yang kompleks atau membingungkan, terutama terkait perilaku hallucinasi dan ketidakpatuhan terhadap perintah.